Corriger les liens cassés avec Semrush : 404, redirections et contrôle
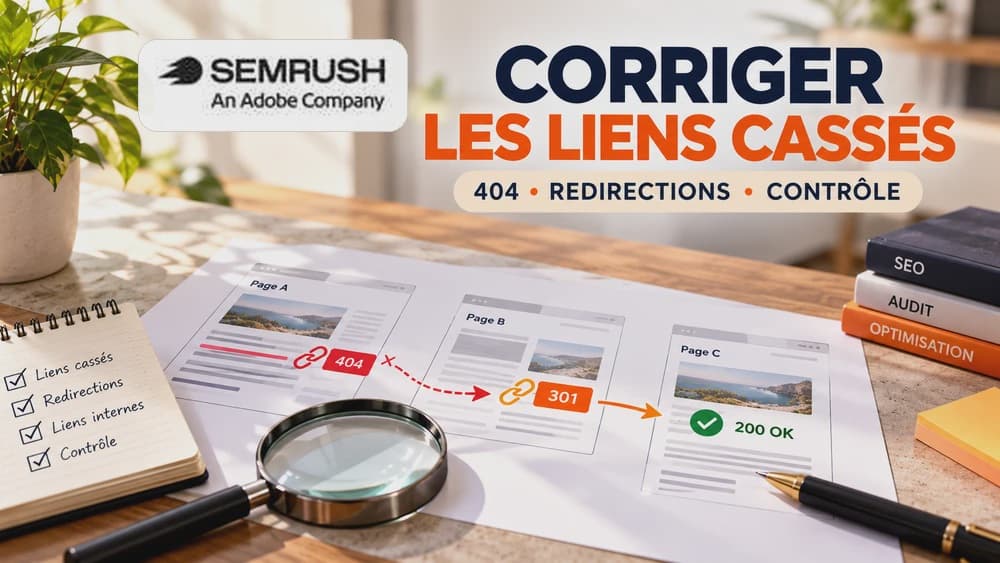
Dans Audit de site, repérez les liens cassés depuis les pages qui pointent vers une URL en échec, vérifiez si la 404 est réelle, puis corrigez le lien, redirigez uniquement vers un équivalent ou retirez la référence.
Liens cassés et erreurs 404 : le problème à résoudre avant toute redirection
Un lien interne cassé conduit un visiteur d’une page existante vers une adresse qui n’affiche plus le contenu attendu. Le problème se situe d’abord dans le lien source : corriger sa destination est souvent plus utile que multiplier les redirections.
Une réponse HTTP 404 peut pourtant être normale : un contenu définitivement supprimé, sans remplacement équivalent, n’a pas à renvoyer vers la page d’accueil. Ce tutoriel traite la réparation des liens et la bonne réponse serveur, pas la configuration complète d’un audit SEO.
Dans Semrush, trouvez les liens concernés plutôt que toutes les alertes du site
Dans un projet Semrush disposant d’un Audit de site terminé, ouvrez le rapport Problèmes (Issues). Recherchez « broken » pour repérer séparément les liens internes cassés et les liens externes cassés, puis ouvrez la liste des pages et des URL concernées.
Le rapport permet de relever à la fois la page qui contient le lien, la destination demandée et le code HTTP constaté par son robot. Conservez ces trois informations : elles évitent de corriger uniquement la page d’erreur en oubliant le lien qui y conduit.
Contrôlez une erreur sur une page prioritaire avant de la généraliser
Commencez par les liens placés dans la navigation, les pages de vente, les tutoriels fréquentés et les pages proches de la conversion. Un lien brisé dans un menu peut affecter plusieurs parcours, tandis qu’une référence oubliée dans une vieille archive n’exige pas la même urgence.
Ouvrez la destination dans un navigateur et vérifiez son vrai code de réponse ainsi que l’URL finale après redirection. Une capture d’audit n’est pas la preuve que tous les visiteurs rencontrent encore le problème : cache, protection anti-robot et réponse temporaire peuvent expliquer un écart.
Choisissez le bon correctif : URL mal écrite, page déplacée ou page supprimée
Si le contenu existe mais que le lien contient une faute, remplacez directement son adresse sur les pages sources. Si le contenu a définitivement déménagé vers une ressource équivalente, corrigez les liens internes et ajoutez, si nécessaire, une redirection permanente 301 de l’ancienne URL vers la nouvelle.
Si la ressource n’existe plus et qu’aucune page réellement équivalente ne peut la remplacer, conservez un vrai statut 404 ou 410 et retirez les liens obsolètes. Évitez les redirections systématiques vers l’accueil : elles désorientent le visiteur et peuvent produire des signaux incohérents.
Distinguez une vraie 404 d’une fausse alerte du robot Semrush
Semrush documente des faux positifs lorsque son robot rencontre une protection anti-bots, un blocage, une indisponibilité DNS, une mise en cache ancienne ou une limitation de débit. Une page qui répond 200 dans votre navigateur peut avoir été inaccessible au moment du crawl.
Avant toute modification, contrôlez au moins une URL affectée depuis un autre contexte et consultez, si vous y avez accès, les journaux du serveur. Si le problème tient au robot, ajustez seulement les réglages de crawl légitimes, puis relancez le contrôle ; ne supprimez pas une page saine pour satisfaire un outil.
Une soft 404 ne se corrige pas comme une simple URL introuvable
Google décrit le cas d’une « soft 404 » : une page affiche un message « introuvable » ou reste vide tout en retournant un code 200. Elle peut être exclue des résultats, même si son serveur donne l’impression technique d’une réponse réussie.
Si le contenu a réellement disparu, faites renvoyer une vraie 404 ou 410 ; s’il a été déplacé, utilisez une redirection pertinente. Si le contenu devrait fonctionner, recherchez plutôt un défaut de chargement ou d’affichage. Comparez avec le rapport d’indexation et l’inspection d’URL de Search Console pour confirmer le diagnostic.
Exemple de triage : trois liens, trois décisions différentes
Exemple pédagogique fictif : une page « /guides/prix-ancien » renvoie 404 mais son article existe désormais sous « /guides/tarifs » ; une image « /photos/photo-retiree » n’existe plus ; une troisième URL est signalée cassée par Semrush alors qu’elle fonctionne dans le navigateur.
Décision : mettre à jour le lien et rediriger l’ancienne page vers sa version équivalente ; retirer la référence à l’image supprimée et laisser une vraie 404 ; examiner le blocage éventuel du robot avant de toucher à la troisième URL. Aucun de ces exemples ne prétend provenir d’un audit réel de Claim26.
Validez la réparation et gardez une courte liste réutilisable
Après publication, testez les liens directement sur les pages sources, pas seulement l’URL finale. Relancez l’analyse ciblée dans Semrush lorsqu’elle est accessible et contrôlez les pages critiques. Les alertes peuvent mettre du temps à disparaître si les résultats ne sont pas encore actualisés.
Une liste de suivi avec la page source, l’ancienne URL, le statut observé, la décision, la nouvelle cible et la date de recontrôle suffit pour éviter les corrections en double. Comparez les clics et impressions dans Search Console sur une période significative avant d’attribuer une variation SEO à la réparation.
Vérifiez ces quatre signaux.
✓La page source et la destination défaillante sont identifiées
✓Une fausse alerte de robot n'est pas traitée comme une suppression réelle
✓Les 301 pointent vers un contenu équivalent, pas systématiquement vers l'accueil
✓Le lien réparé est recontrôlé depuis la page source
Besoin de savoir si Semrush mérite une place dans votre stack ?
Consultez l’offre du logiciel et vérifiez ses prix, ses limites et ses fonctionnalités avant de choisir un abonnement.
Les points sensibles sont recoupés avant publication.
Les prix et fonctions logicielles peuvent évoluer. Les sources ci-dessous permettent de contrôler les informations qui influencent la décision.